Excel 数据右对齐工具
Excel 数据右对齐工具
Excel 数据右对齐工具
1. 前言
在数据处理工作时遇到了需要将Excel表格中的数据向右对齐的情况,因数据量大,不便手动操作。于是写了一个小工具,它可以自动将Excel表格中的数据右对齐到指定位置,并在左侧填充指定值。
2. 功能
- 数据右对齐:将每行数据向右移动到指定列位置
- 灵活填充:在左侧空出的位置填充用户指定的值(可以是数字、字符串等)
- 批量处理:自动处理整个工作表的所有行数据
- 格式保持:确保输出数据保持整齐的表格格式
3. 部分代码
3.1 右对齐实现原理
工具的核心算法逻辑如下:
- 读取原始Excel数据,忽略标题行
- 对每一行数据:
- 提取所有非空值
- 计算需要填充的数量(目标位置 - 当前数据长度)
- 在数据左侧添加指定数量的填充值
- 确保所有行长度一致
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
def right_align_data(excel_path, sheet_name, align_position, fill_value):
    # 读取Excel文件
    df = pd.read_excel(excel_path, sheet_name=sheet_name, header=None)

    # 创建新的DataFrame,预先分配所有列
    new_data = []

    # 处理每一行数据
    for _, row in df.iterrows():
        valid_values = [v for v in row.values if pd.notna(v)]
        fill_count = max(0, align_position - len(valid_values))
        new_row = [fill_value] * fill_count + valid_values
        new_data.append(new_row[:max_cols])

    return pd.DataFrame(new_data)
3.2 性能优化
工具特别针对大数据量处理进行了优化:
- 避免DataFrame碎片化:预先确定总列数,一次性构建数据,而不是逐列添加
- 高效内存使用:使用列表收集处理后的数据,最后一次性转换为DataFrame
- 简洁的数据处理:直接操作原始值列表,减少pandas操作开销
4. 使用方法
4.1 命令行调用
1
python excel_align.py <excel_path> <sheet_name> <align_position> <fill_value>
示例:
1
python excel_align.py data.xlsx Sheet1 12 0
4.2 参数说明
excel_path:要处理的Excel文件路径sheet_name:要处理的工作表名称align_position:右对齐的目标列位置(从1开始计数)fill_value:用于填充左侧空位的值(可以是数字或字符串)
4.3 输出结果
处理完成后,工具会在原始文件同目录下生成一个新的Excel文件,文件名在原文件名后添加”_aligned”后缀。例如:
1
2
原始文件: data.xlsx
处理后文件: data_aligned.xlsx
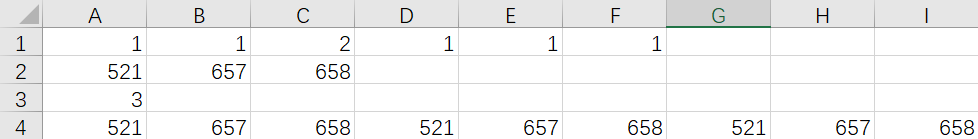 原始数据
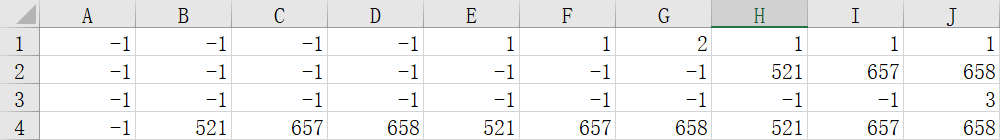 处理后的数据
5. Code
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
import pandas as pd
import sys
import os

def right_align_data(excel_path, sheet_name, align_position, fill_value):
    """
    将Excel表格中的数据右对齐到指定位置,并在左侧填充指定值

    参数:
    excel_path (str): Excel文件路径
    sheet_name (str): 要处理的sheet名称
    align_position (int): 右对齐的目标位置
    fill_value: 要填充的值

    返回:
    pd.DataFrame: 处理后的数据
    """
    # 读取Excel文件,指定header=None表示没有标题行
    df = pd.read_excel(excel_path, sheet_name=sheet_name, header=None)

    # 计算最大列数
    max_cols = align_position

    # 创建新的DataFrame,预先分配所有列
    new_data = []

    # 处理每一行数据
    for _, row in df.iterrows():
        # 获取当前行的非空值
        valid_values = [v for v in row.values if pd.notna(v)]

        # 计算需要填充的数量
        fill_count = max(0, align_position - len(valid_values))

        # 创建新的数据列表:先填充指定值,再添加原始数据
        new_row = [fill_value] * fill_count + valid_values

        # 确保行长度一致
        if len(new_row) < max_cols:
            new_row += [fill_value] * (max_cols - len(new_row))

        new_data.append(new_row[:max_cols])

    # 创建新的DataFrame
    result_df = pd.DataFrame(new_data)

    return result_df

def main():
    """主函数,处理命令行参数并执行右对齐操作"""
    # 检查命令行参数
    if len(sys.argv) != 5:
        print("用法: python excel_align.py <excel_path> <sheet_name> <align_position> <fill_value>")
        print("示例: python excel_align.py data.xlsx Sheet1 12 0")
        sys.exit(1)

    # 获取命令行参数
    excel_path = sys.argv[1]
    sheet_name = sys.argv[2]

    try:
        align_position = int(sys.argv[3])
    except ValueError:
        print("错误: 右对齐位置必须是整数")
        sys.exit(1)

    # 尝试将填充值转换为适当的类型
    try:
        fill_value = int(sys.argv[4])
    except ValueError:
        try:
            fill_value = float(sys.argv[4])
        except ValueError:
            fill_value = sys.argv[4]

    # 检查文件是否存在
    if not os.path.exists(excel_path):
        print(f"错误: 文件 '{excel_path}' 不存在")
        sys.exit(1)

    # 执行右对齐操作
    try:
        result_df = right_align_data(excel_path, sheet_name, align_position, fill_value)

        # 构建输出文件名
        base_name, ext = os.path.splitext(excel_path)
        output_path = f"{base_name}_aligned{ext}"

        # 保存结果,指定header=False表示不写入列标题
        result_df.to_excel(output_path, index=False, header=False)
        print(f"处理完成! 结果已保存到: {output_path}")

    except Exception as e:
        print(f"处理过程中发生错误: {e}")
        sys.exit(1)

if __name__ == "__main__":
    main()
This post is licensed under CC BY 4.0 by the author.